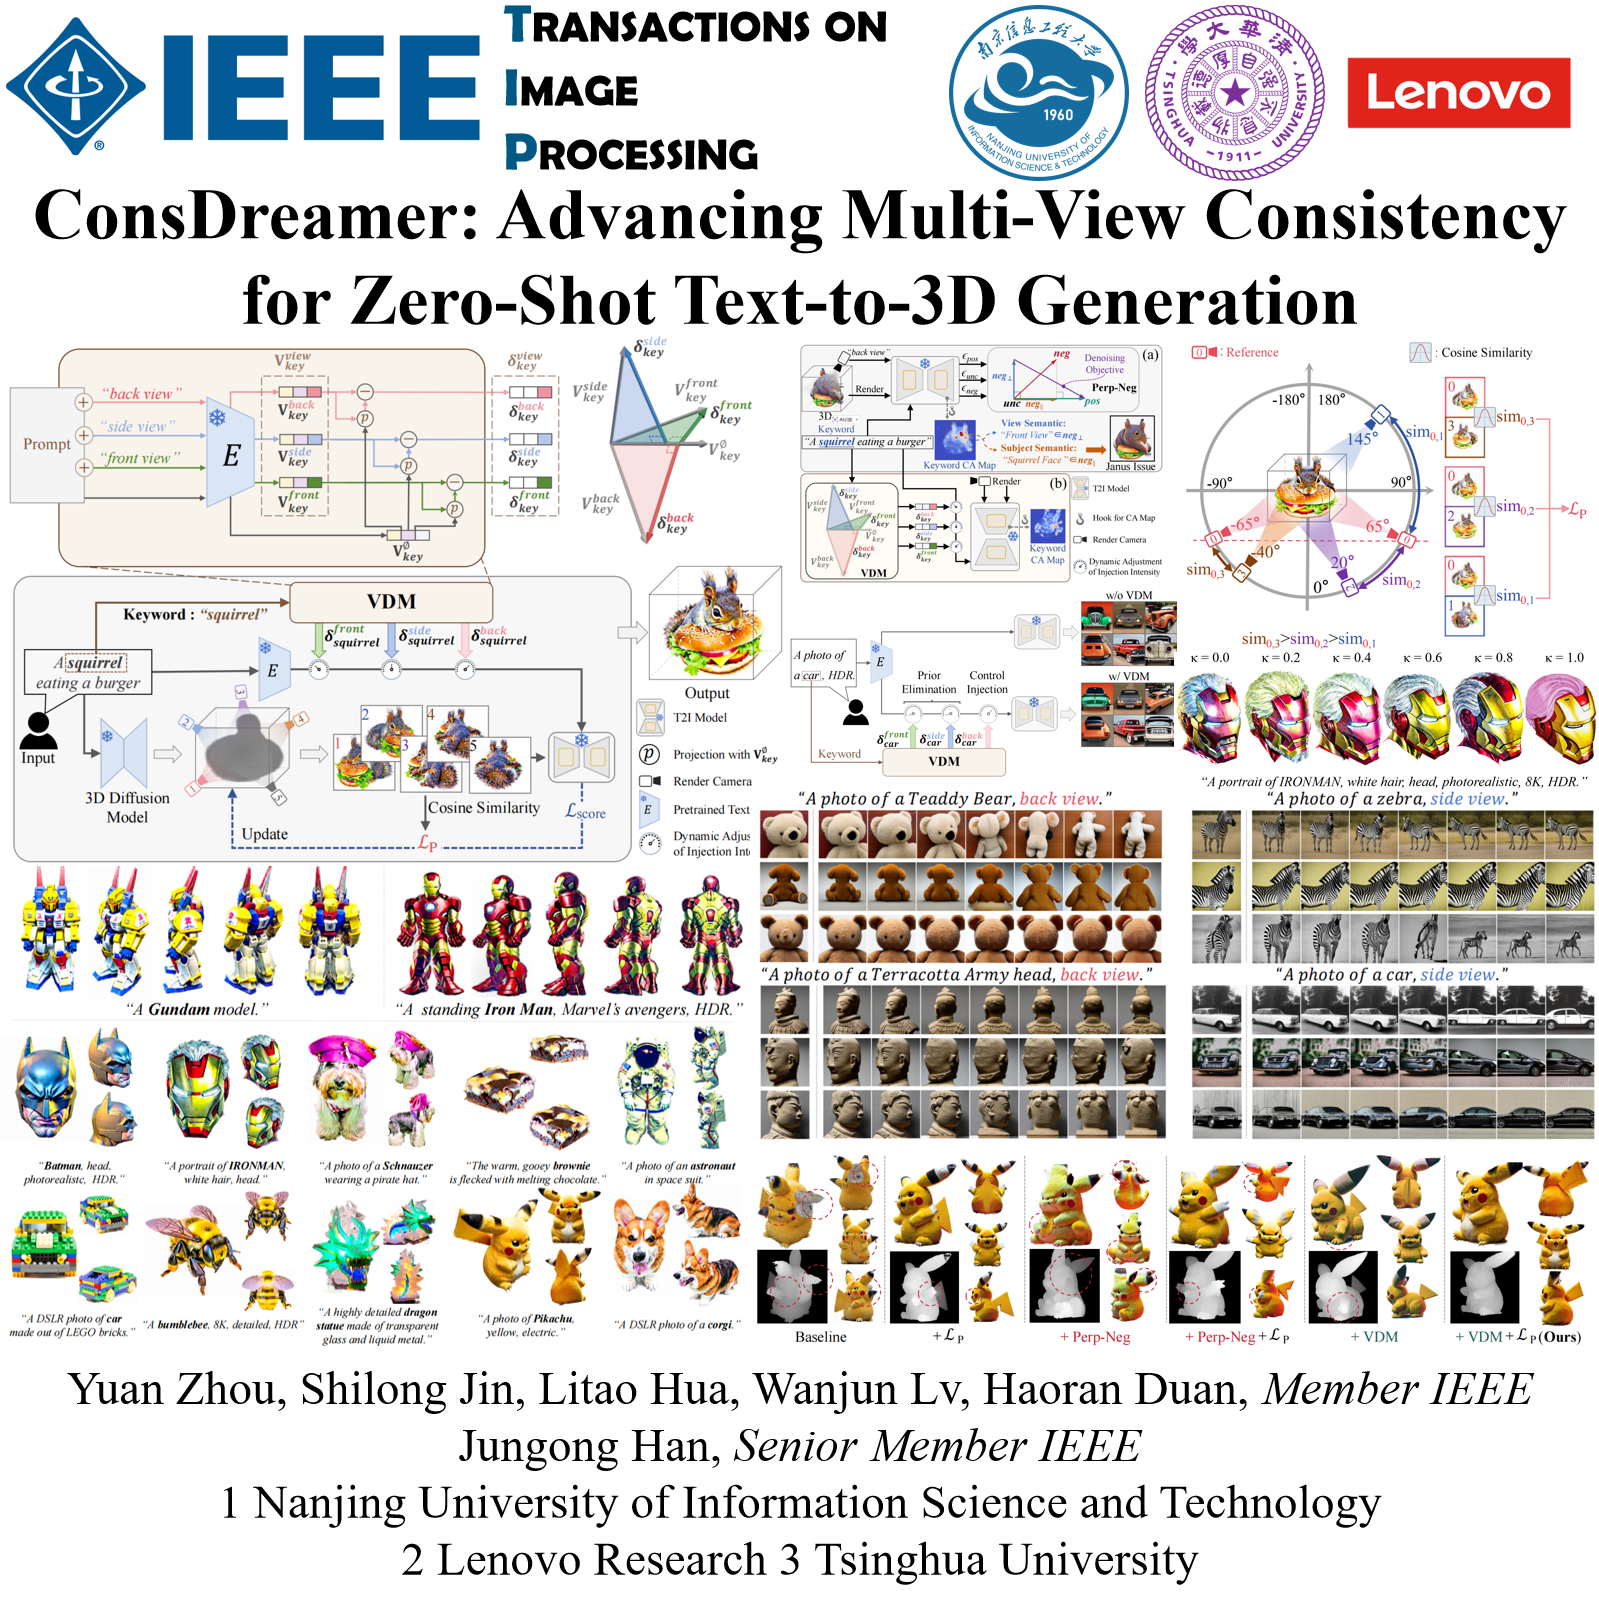
ConsDreamer: Advancing Multi-View Consistency for Zero-Shot Text-to-3D Generation
Yuan Zhou, Shilong Jin, Litao Hua, Wanjun Lv, Haoran Duan, Jungong Han
Advancing multi-view consistency for zero-shot text-to-3D generation.
My work focuses on 3D generation, multimodal perception, zero-shot learning, and video understanding.

Yuan Zhou, Shilong Jin, Litao Hua, Wanjun Lv, Haoran Duan, Jungong Han
Advancing multi-view consistency for zero-shot text-to-3D generation.

Fan Liu, Qihiang Wang, Yifan Zhu, Lei Xiang, Shilong Jin, Yuan Zhou
Semantic-controlled virtual-to-real image conversion for maritime unmanned boats.

Yuan Zhou, Litao Hua, Shilong Jin, Wentao Huang, Haoran Duan
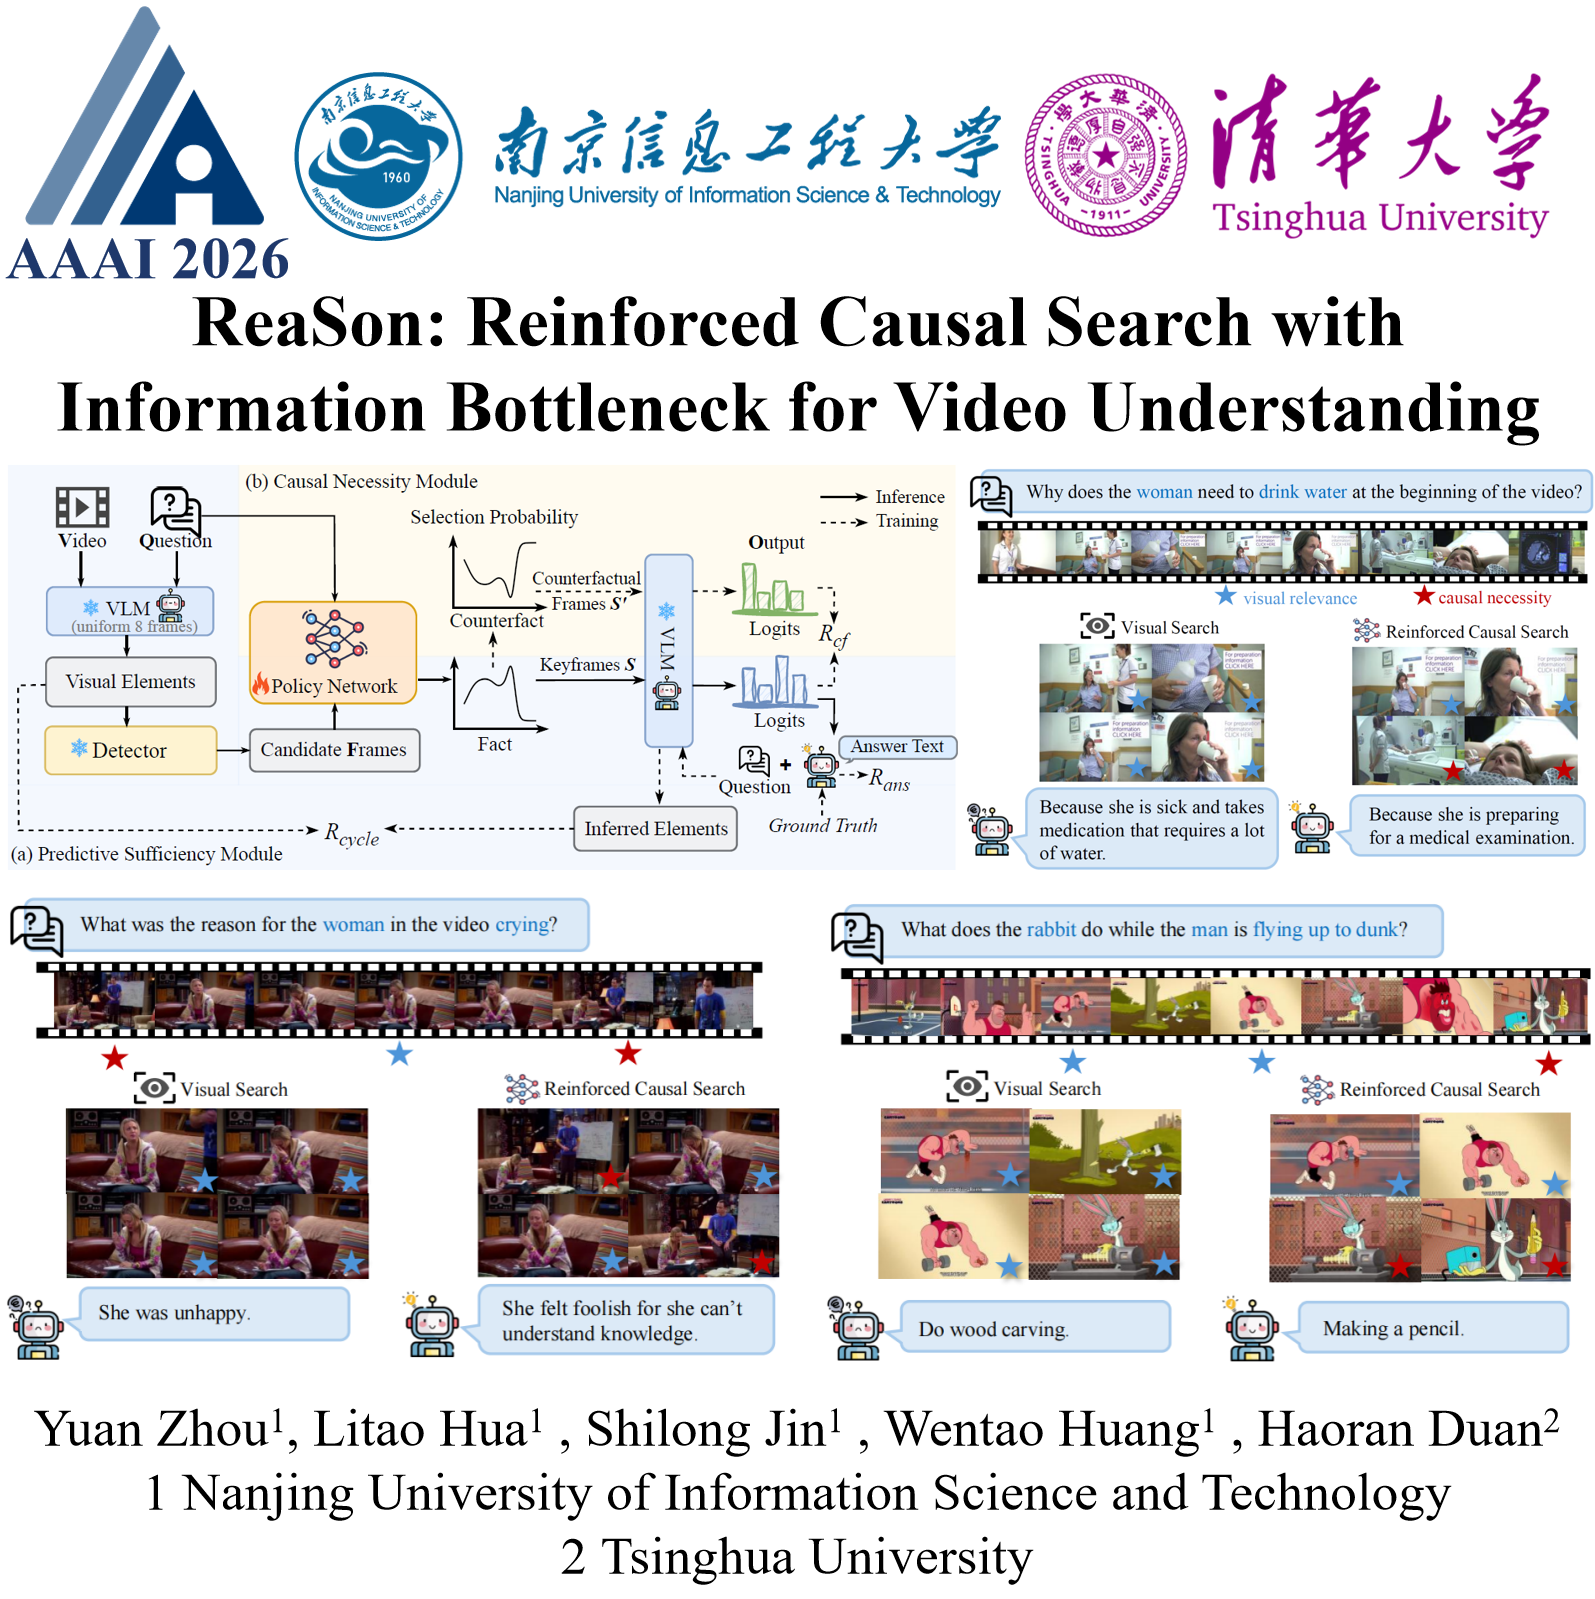
Reinforced causal search with information bottleneck for video understanding.

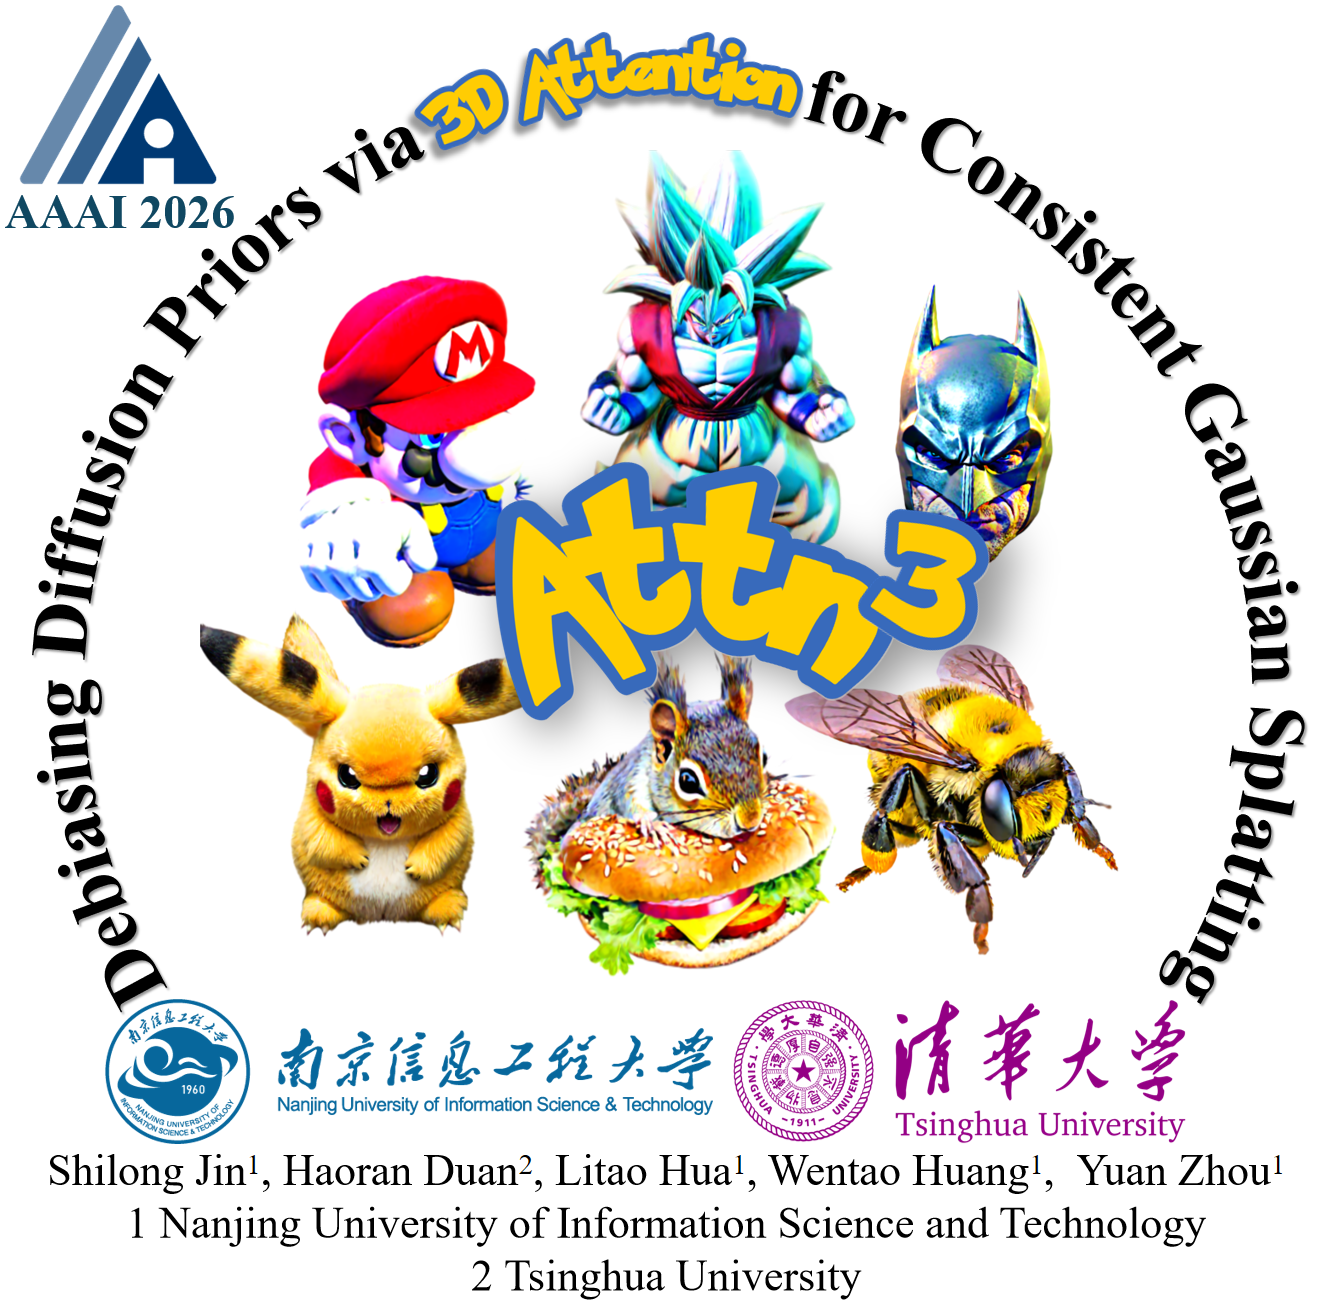
Shilong Jin, Haoran Duan, Litao Hua, Wentao Huang, Yuan Zhou
Debiasing diffusion priors with 3D attention for consistent Gaussian splatting.

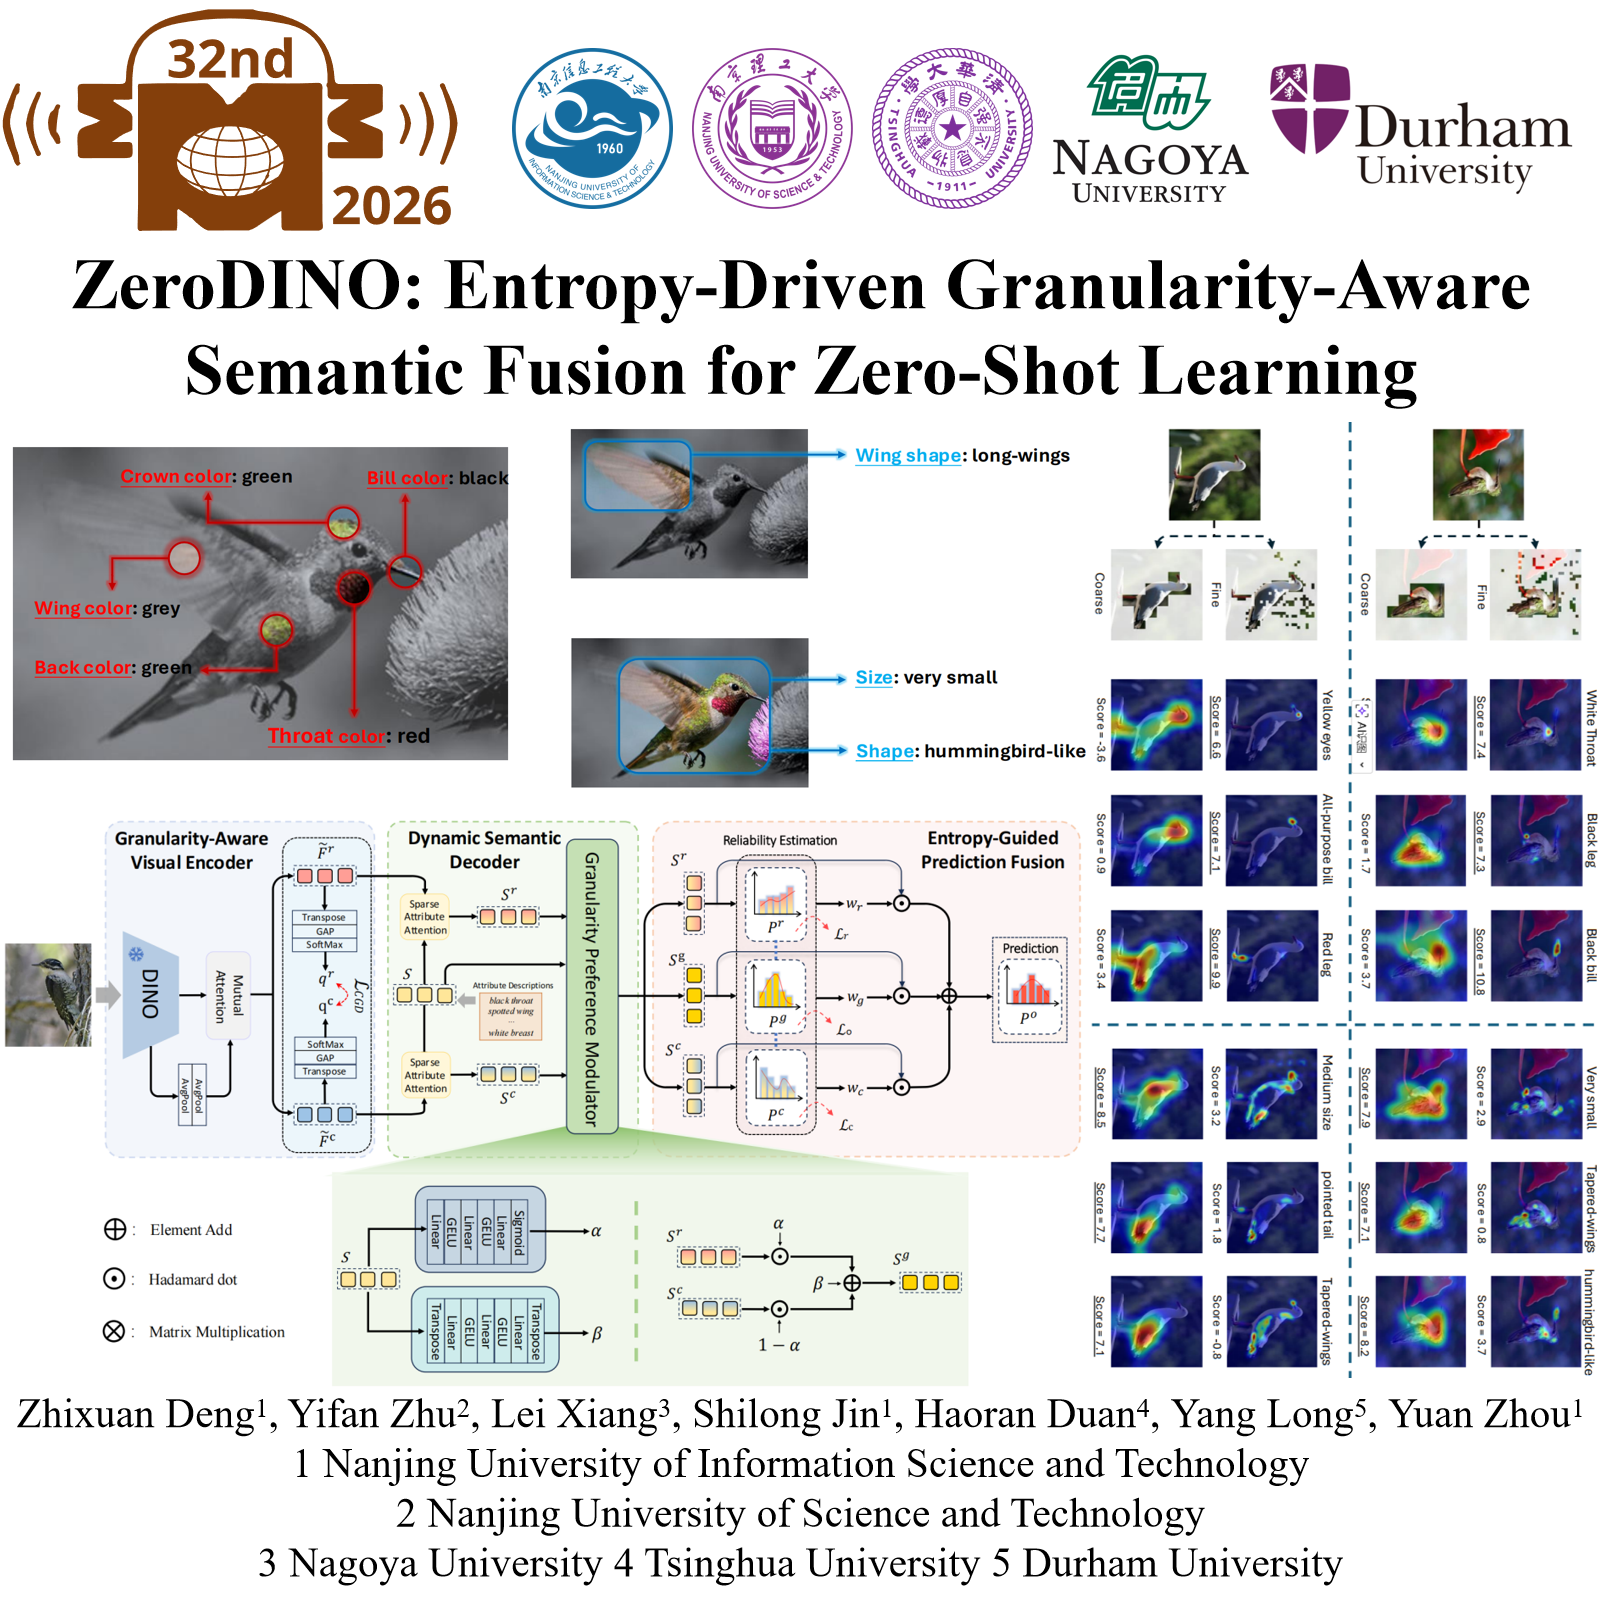
Zhixuan Deng, Yifan Zhu, Lei Xiang, Shilong Jin, Haoran Duan, Yang Long, Yuan Zhou
Entropy-driven, granularity-aware semantic fusion for zero-shot learning.

Inventors: Yuan Zhou, Shilong Jin